苏泰至强深度学习工作站 4/5代单路四卡GPU塔式服务器深度解析
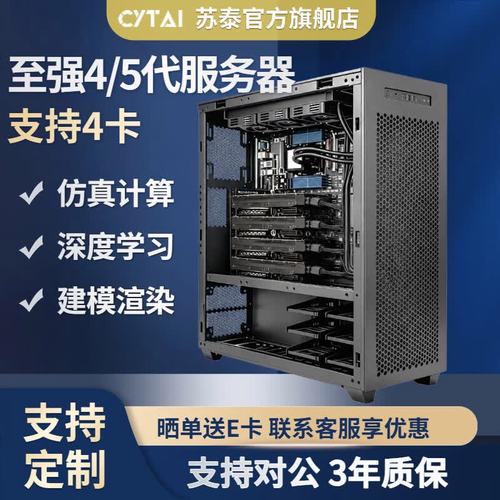
随着人工智能、深度学习和大模型训练的飞速发展,本地算力需求呈现爆发式增长。传统双路服务器虽然扩展性强,但成本高、功耗大,对中小规模实验室和团队并不友好。苏泰至强深度学习工作站应运而生——基于第四代/第五代Intel Xeon处理器,提供单路四卡(支持NVIDIA RTX 5090、Pro 6000等高端GPU)的塔式服务器解决方案,兼顾强劲性能与静音低耗,成为AI研究人员与初创公司的热门选择。\n\n核心处理器:单路至强,性能直立 \n该工作站搭载Intel第四代(Sapphire Rapids)或第五代(Emerald Rapids)Xeon可扩展处理器。单路配置即可提供最高60核心、120线程的算力,支持8通道DDR5内存,带宽高达4800MT/s。对于多数深度学习任务(如图像分类、目标检测、大语言模型微调),单路CPU已绰绰有余,且避免了双路平台NUMA跨节点带来的编程复杂度。处理器集成AMX(高级矩阵扩展)指令集,可加速INT8/FP16推理与训练,进一步解放GPU负载。\n\nGPU架构:单路四卡,至强搭配Gen5通道 \n工作站最突出的亮点是单路直连四张顶级GPU。借助第四代/第五代Xeon的PCIe 5.0通道拆分功能,每张GPU均可获得x8或x16的Gen5链路,彻底打破传统PCIe 4.0下的带宽瓶颈。\n- RTX 5090:最新旗舰游戏与创作卡,但凭借强大的FP16及新一代光追性能,也可用于多模态训练。32GB GDDR7显存可承载中等规模模型。\n- NVIDIA Pro 6000(原RTX 6000 Ada) :专业视觉计算卡,48GB ECC显存,专为AI训练与推理优化,支持vGPU与深度学习框架。四卡并置后显存高达192GB,可并行训练十亿参数级模型。\n\n为了保证四卡高负载运行时不降频,工作站采用定制风道与涡轮/轴流混合散热方案。GPU间通过NVLink桥接器(部分型号支持)或PCIe Switch可提升卡间通信效率,同时整机支持双850W或双1200W冗余电源,提供稳定动力。\n\n紧凑塔式架构:企业级拓展,工作站静音 \n虽为塔式结构,内部却采用类似机架式服务器的主板与插槽布局。主板通常配备3-4条PCIe 5.0 x16物理插槽,支持四张双宽GPU或两张三宽GPU。存储方面提供最多8个2.5英寸热插拔盘位与2个M.2 NVMe插槽,可组建RAID阵列保证数据安全。网络连接内置双万兆以太网或可选光纤模块,满足分布式训练需求。\n\n相比机架服务器,塔式机箱风噪控制出色,满载噪音不大于45dB(A),适合办公室或实验室放置。配合完善的IPMI远程管理,用户可通过网页界面监控每张GPU的温度、功耗与利用率。\n\n适用场景 \n- 计算机视觉团队批量训练与推理\n- 大语言模型LoRA微调及小型全参数训练\n- 涉密环境的离线AI开发\n- 医疗影像分析与药物筛选仿真\n- 高校无人机、自动驾驶算法验证\n\n如需进一步调整应用方向或扩展说明,可补充硬件参数计算案例。苏泰单路多卡工作站完美结合了至强直连的创新架构与强大GPU集群,是小体积大算力需求的理想落脚点。该机型适用于需要高计算密度但又无法利用大型机房的团队,尤其在多卡互联工程与AI集群搭建中提供磐石级支撑。下一篇文章中将探讨PCIe带宽分配操作实务及多卡驱动设置说明。
}
如若转载,请注明出处:http://www.dshike.com/product/62.html
更新时间:2026-10-11 03:39:08